

原文:Measurements for understanding the pace of AI development inside frontier labs(2026-09-17)。作者 Marina Favaro、Phillie Wright。 这篇的价值不在“又一组数字”,而在把 RSI 变成别人可以复核的指标。
一句话
如果外界只能看到模型发布会,就永远无法判断“AI 造 AI”到了哪一步。作者给出三项可以定期公布、并交给第三方核验的测量:AI 做了多少研发、agent 被监督得怎么样、算力花在哪。
指标一:AI 主导的 AI 研发比例
做法是给 Anthropic 内部所有 AI 研发任务建一棵任务树,再按 Epoch AI 的自动化等级(AL0–AL5)逐项打分,用投入的人时加权,得到一个“研发自动化指数”。
| 等级 | 含义 |
|---|---|
| AL0 | 没有 AI 参与 |
| AL1 | 极少 AI 参与 |
| AL2 | AI 辅助 |
| AL3 | AI 协作:在人类密切指导下完成大块工作 |
| AL4 | AI 主导:只需高层指令,人类监督 |
| AL5 | 完全自主,人类不在环内 |
2026 年 8 月的结果:
- 没有任何一个被测子集达到完全自主(AL5)。
- Claude 主导 26% 的 AI 研发工作(2 月还不到 1%)。
- 达到“协作”及以上的比例超过 90%。
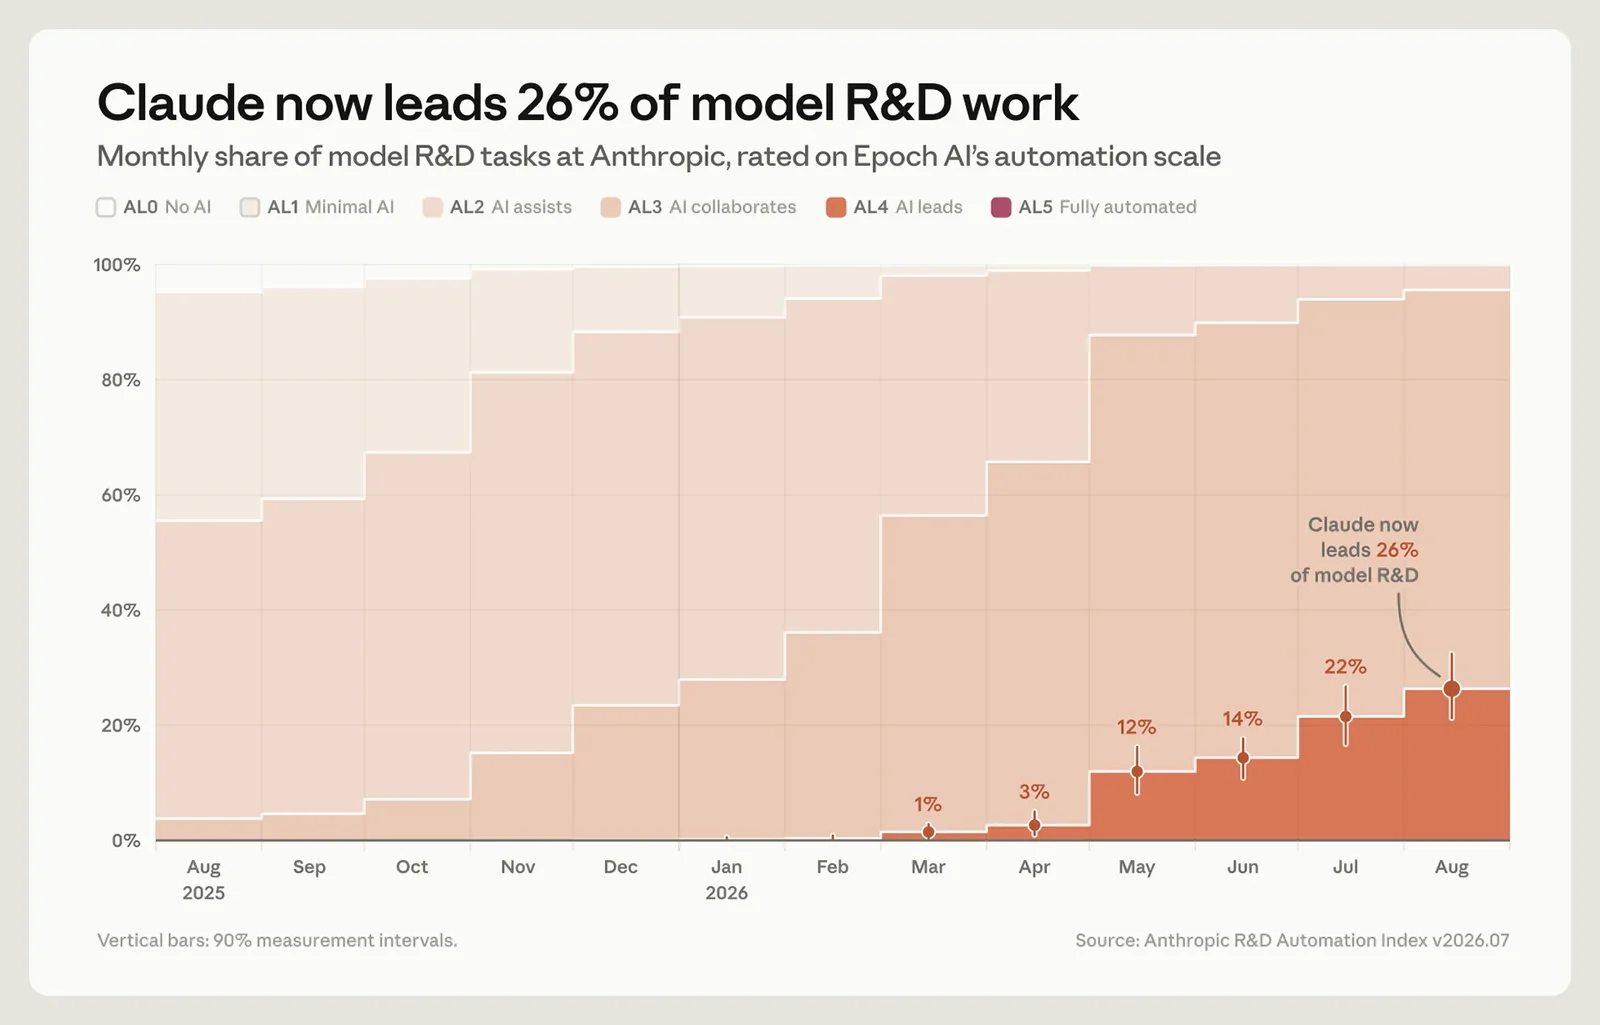
图:按月统计的模型研发任务份额,按自动化等级着色。2026 年 8 月“AI 主导”(AL4)为 26%,纵向短线是 90% 测量区间。
方法细节值得看一眼:从 2026 年 7 月每周随机抽取各部门 20% 的员工,让 Claude 阅读其 Slack 和文档,整理出约 1.5 万个细粒度任务,再汇总成 542 个节点、378 个叶子的任务树;每个节点由 Claude 调研并打分。人工复核与模型判断“相差不超过一级”的比例是 97%,而人类评审者彼此的一致率只有 35%——作者用这个来回应“模型评委不可信”。
指标二:对 agent 的监督
- 内部最常用的平台上,同时约有 3 万个 agent 在做研究和工程工作。
- 在线监控:100% 的 agent 动作在执行前过一遍监控,通常几秒内完成;2026 年 8 月超过十亿次决策里约 0.002%(约 1/47000)被拦截。
- 离线监控:100% 的动作在事后被读入;每周约 10 万条会话被标记,约 1–2‰ 的会话进入进一步审查,最高优先级的约 每周 50 条 升级到人工。
作者想说明的是一种比例感:单个 agent 很少出事,但当成千上万个 agent 并行工作时,罕见事件会变成常态。
指标三:算力分配
取 2026 年 7 月 13–20 日一周的快照:约 6% 的 AI 研发算力用于安全工作;如果只看“AI 驱动的 AI 研发”,这个比例约为 12%。
这是个保守估计:既推进能力又推进安全的工作,一律算作能力。作者也承认,算力份额只反映“花了多少”,不反映“做了多少安全研究”。
作者自己列出的局限
- 评委是自家模型,可能和被测模型犯同样的错。
- 任务篮子被冻结:指数上涨说明“2026 年 7 月那些活”在被自动化,不说明有没有出现新工种。
- 算力分类依赖自动标签,可能标错。
- 只有一周数据,能证明“可以测”,不能证明“有趋势”。
为什么值得读
RSI 讨论最容易被两种话术带走:一种是“还早”,一种是“已经来了”。这篇的贡献是给出中间地带——分级、加权、可复核,并且主动把方法论和缺陷摊开。它也是 03 调速方案 里“嵌入式外部评审员”要看的那些数。
读的时候可以问:26% 是按人时加权的“任务份额”,如果按算力或按影响加权,会是多少?换一家实验室、换一棵任务树,这个数字还能横比吗?