

原文:When AI builds itself(The Anthropic Institute,2026-06-04,2026-09-18 更新)。作者 Marina Favaro、Jack Clark。 这一页是阅读笔记,不是译文;引用的数字都注明口径。
一句话
AI 已经在相当大程度上参与“造下一代 AI”,而且这条曲线还在变陡;但人类仍掌握选题与研究品味,所以现在既不是“已经闭环”,也不该假设“一定会闭环”。
五个阶段
作者把“人机分工”的演变画成一条线:
| 阶段 | 时间 | 人的角色 |
|---|---|---|
| 造第一个 Claude | 2021–2023 | 像普通科技公司:人写代码和文档 |
| 聊天机器人 | 2023–2025 | 人用聊天机器人生成代码片段,再复制进编辑器 |
| 编码 agent | 2025–2026 | agent 自己写、改整个文件 |
| 自主 agent | 现在 | agent 自己跑代码,把数小时的工作转包给其他 agent |
| 闭环 | 20XX? | agent 能自己构建并训练模型;Claude 持续改进 Claude |
关键限定词:还没有到第五阶段,而且 RSI 不是必然。
外部证据:能力曲线的斜率变了
- METR 测的“可靠完成任务的时长”,翻倍周期从约 7 个月缩短到约 4 个月。
- 2024 年 3 月 Opus 3 大约能完成人类 4 分钟的任务;一年后 Sonnet 3.7 约 1.5 小时;再一年后 Opus 4.6 约 12 小时。按这个趋势,2027 年可能是“周”级任务。
- SWE-bench(真实开源仓库修 bug)两年内从个位数分数到饱和;CORE-Bench(复现论文结果,做原创研究的前提)从约 20% 到饱和只用了 15 个月。
这些是公开基准,能说明“能力”,但说明不了“AI 对 AI 研发本身的影响”。所以下一节才是重点。
内部证据:AI 已经在加速 AI 研发
1. 代码。 2026 年 5 月,合并进代码库的代码 80% 以上由 Claude 撰写;Claude Code 2025 年 2 月发布研究预览之前,这个数字是个位数百分比。
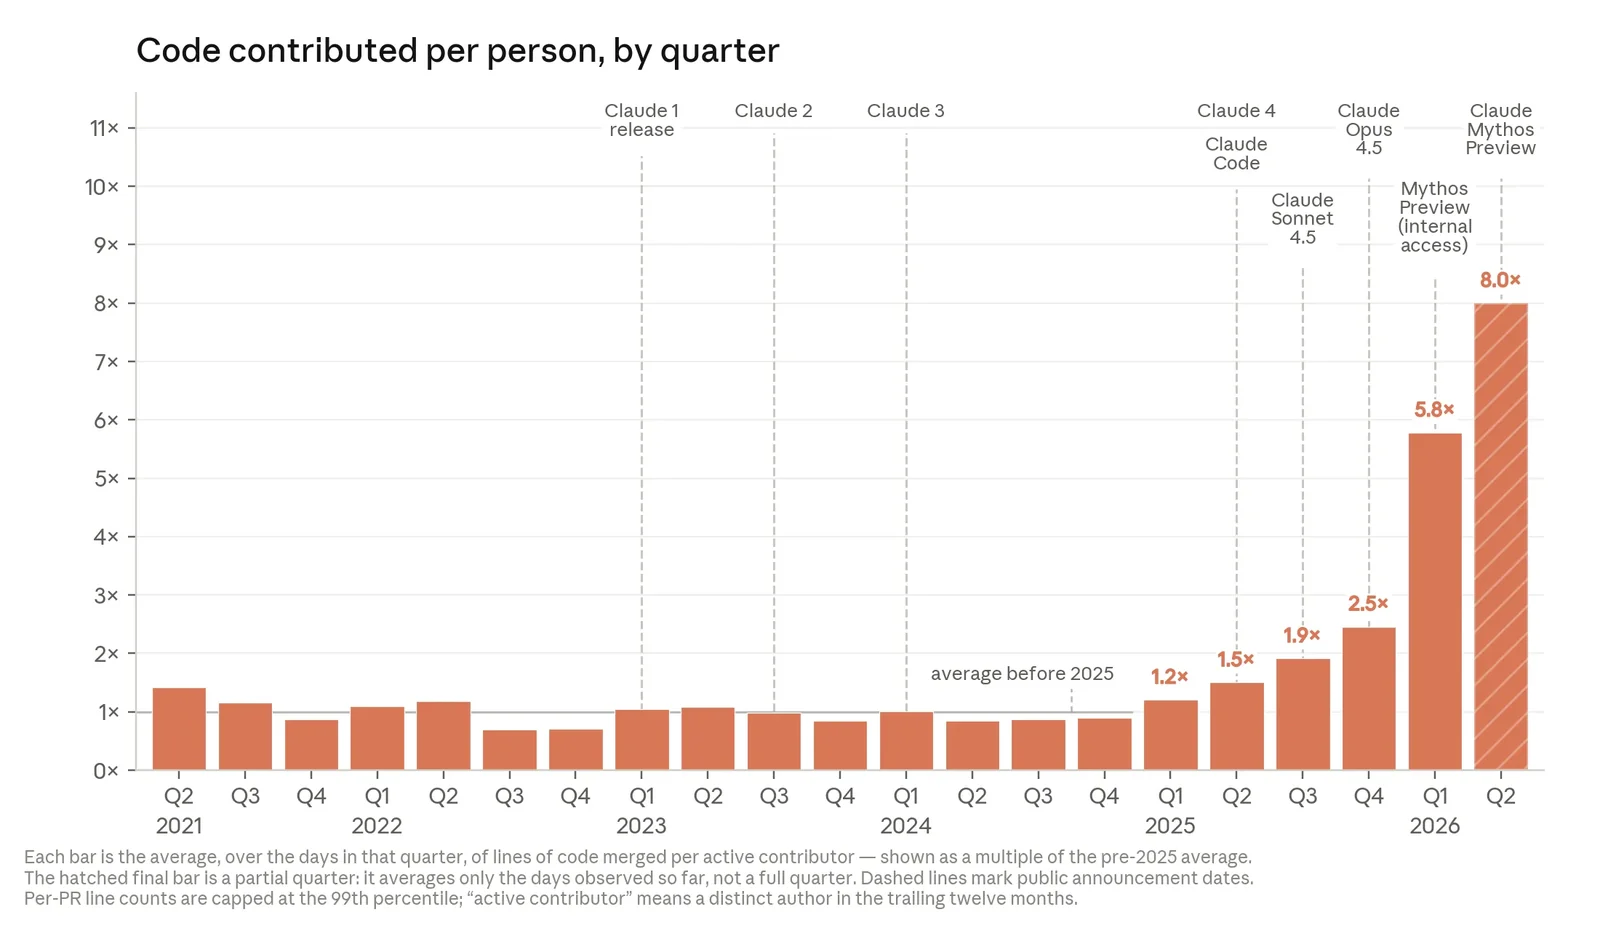
图 1:每人每季度合并的代码量,以 2025 年前的平均值为 1×。2026 年第二季度达到 8.0×(斜纹柱是未完整季度)。图注同时提醒:代码行数只衡量数量,不代表质量。
2. 实验执行。 每次发新模型,团队都跑同一个测试:给 Claude 一段训练小模型的代码,让它在通过正确性检查的前提下尽量提速。2025 年 5 月 Opus 4 平均约 3×,2026 年 4 月 Mythos Preview 约 52×;熟练人类研究员花 4–8 小时大约能到 4×。作者的原话是:在“明确实验内的优化”这件事上,Claude 不到一年从“非常好用”变成了“超人”。
3. 研究与判断。 2026 年 4 月,Claude agent 在“弱模型能否可靠监督强模型”这个开放问题上,5 天、800 个累计小时、约 1.8 万美元算力,把性能差距追回 97%;两位人类研究者一周做到约 23%。另一个测试让模型只看“研究者走弯路之前”的会话,猜下一步:2025 年 11 月的 Opus 4.5 在 51% 的情况下比人类选得更好,2026 年 4 月升到 64%(样本是 129 个“人类选择有改进空间”的时刻,不是随机对比)。
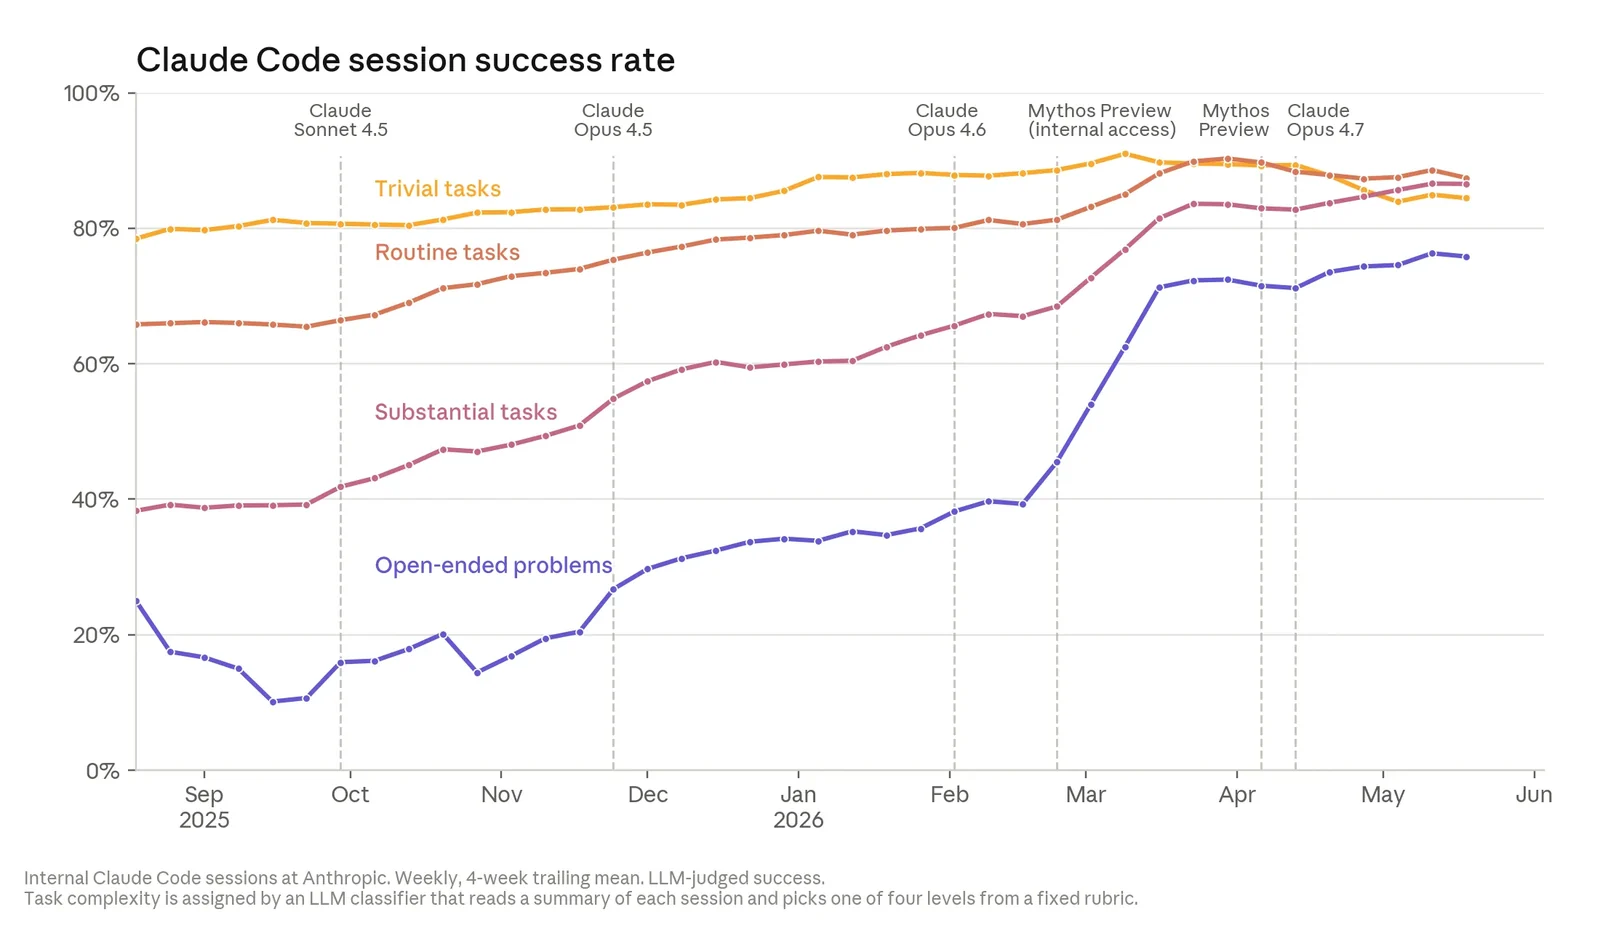
图 2:Claude Code 内部会话成功率,按任务难度分四档。开放式问题从约 25% 升到 2026 年 5 月的约 73%,与简单任务的差距在收窄。成功率由 Claude 评委判定。
一张数字表
| 指标 | 数字 | 口径提醒 |
|---|---|---|
| Claude 撰写的合并代码 | >80% | 2026-05,按合并行数归因;公司高管公开说过“90% 以上” |
| 人均代码产出 | 8× | 2026 Q2 对 2025 年前均值;原文开头写作“每季度”,图表是“每天” |
| 实验提速 | 3× → 52× | 同一个微型实验,不是真实训练速度 |
| 自动研究追回差距 | 97% vs 23% | 单一任务、单一数据集,未迁移到生产 |
| 选下一步超过人类 | 51% → 64% | 只统计人类有改进空间的时刻 |
| 员工自报提效 | 约 4× | 2026-03 调查 130 人,作者承认真实值更低 |
三种未来
- 趋势停滞,但今天的能力扩散开。 指数曲线其实是 S 曲线;研究品味无法靠堆算力和数据获得;或者瓶颈在能源、芯片、供应链。作者认为这种可能性不高,因为它会给出最多适应时间。
- 实验室继续获得复利式效率,人保留方向与判断。 这是作者认为最可能的情景:100 人的公司做 1 万人的事;但某个环节提速会把瓶颈推到别处,Anthropic 自己已经撞上“人类代码评审跟不上生成速度”。
- AI 真正闭环,开始构建继任者。 进度由算力和算法效率决定,人类转向监督、验证、审计;对齐能否解决是最不确定的部分。
值得追问
- “8 倍代码”里有多少是质量提升、多少只是行数?文章自己承认行数不是好指标。
- 97% 的那个实验,人类只负责选题和评分标准;如果选题也被自动化,结论还成立吗?
- 三种未来里,作者对“停滞”的否定理由是“我们还没看到曲线弯”,这更像观察而不是论证。
- 最后落到“可验证的减速”:如果减速无法验证,单边暂停只会换一个领跑者。这句话在 03 里展开。